تروي كتب التراث أن ابنة أبي الأسود الدؤلي رفعت رأسها ذات ليلة إلى السماء، فدار بينها وبين أبيها هذا الحوار:
«ما أحسنُ السماءِ؟»
«نجومها».
«لم أسأل، بل تعجّبتُ».
«إذن قولي: ما أحسنَ السماءَ!»
وتقول الرواية إن هذه الحادثة كانت من أسباب نشأة علم النحو. فالجملة المكتوبة بلا حركات تحتمل السؤال والتعجب معاً، ولا يحسمها إلا الضبط.
المفارقة أن الغموض الذي أربك الأب يربك الحاسوب اليوم أيضاً. فالعلاقة بين الذكاء الاصطناعي واللغة العربية لا تزال أعقد مما يبدو: تكتب النماذج فقرات بليغة، ثم تتعثر أمام جملة قصيرة بلا تشكيل. فهل يفهم الذكاء الاصطناعي اللغة العربية حقاً؟
ولا يتعلق الأمر بترف أكاديمي. فمئات الملايين يكتبون بالعربية يومياً في الرسائل والبحث والعمل والدراسة، ويطلبون من المساعدات الذكية أن تفهمهم من المرة الأولى. وكل خطأ في الفهم يعني وقتاً ضائعاً أو معلومة مشوّهة. لذلك نفكّك في هذا المقال أسباب التعثر، ونتعرف على النماذج اللغوية العربية الجديدة، ثم نختم بنصائح تفيدك في استخدامك اليومي.
المحتويات
كيف «تقرأ» الآلة اللغة؟ مدخل مبسّط إلى معالجة اللغة الطبيعية
قبل أن نحاسب النماذج، لنفهم كيف تشتغل في ميدان الذكاء الاصطناعي واللغة العربية. فالآلة لا تقرأ الكلمات كما نفعل نحن. إنها تقطّع النص إلى وحدات صغيرة تسمى الرموز (Tokens)، وتحوّل كل وحدة إلى أرقام، ثم تتعلم من مليارات الأمثلة أيّ رمز يأتي بعد الآخر. هذه هي فكرة النماذج اللغوية الكبيرة (LLMs)، وهي الأساس الذي تقوم عليه معالجة اللغة العربية حاسوبياً وغيرها من اللغات.
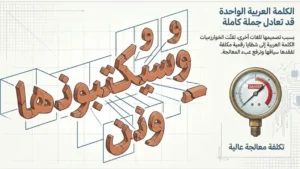
هنا تبدأ المشكلة. فمعظم أدوات التقطيع صُمّمت أولاً حول الإنجليزية، ولذلك تفتّت الكلمة العربية الواحدة أحياناً إلى شظايا بلا معنى واضح. وكلما زادت الشظايا ارتفعت كلفة المعالجة وقلّ ما يتسع له النموذج من نص. أضف إلى ذلك أن البيانات العربية المتاحة للتدريب أصغر بكثير من نظيرتها الإنجليزية، فتتعلم النماذج من أمثلة أقل وأفقر. باختصار، تكمن العقدة في البيانات والتصميم أكثر مما تكمن في «ذكاء» الآلة.
ولتسهيل ما يأتي، إليك أربعة مصطلحات تتكرر في هذا المجال:
- الرمز (Token): قطعة صغيرة من النص، قد تكون كلمة أو جزءاً منها.
- التوسيم (Annotation): إضافة معلومات إلى النص، مثل نوع الكلمة وجذرها، ليتعلم منها النموذج.
- المدوّنة (Corpus): مجموعة ضخمة من النصوص المستخدمة في التدريب.
- مفتوح الأوزان (Open-weight): نموذج يمكن تنزيله وتشغيله دون الاعتماد على شركة بعينها.
تحديات اللغة العربية في الذكاء الاصطناعي: التشكيل والاشتقاق وحرية الترتيب
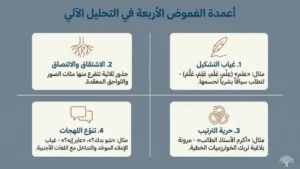
ترصد دراسة محكّمة حديثة في مجلة جامعة القاسمية عوامل رئيسية ترفع الغموض في النص العربي وتُضعف دقة التحليل الآلي. وتأتي في مقدمتها غياب التشكيل، وغنى النظام الصرفي، ومرونة ترتيب الجملة، وتنوّع اللهجات. ويلخّص الجدول التالي أبرز تحديات اللغة العربية في الذكاء الاصطناعي بأمثلة.
| التحدي | مثال | لماذا يربك الآلة؟ |
|---|---|---|
| غياب التشكيل | «علم» تُقرأ: عِلم، عَلَم، عَلِمَ، عَلَّمَ | كلمة واحدة بعدة معانٍ، ولا يحسمها إلا السياق |
| الاشتقاق والالتصاق | «وسيكتبونها» تختصر جملة كاملة | تحمل عطفاً وزمناً وفعلاً وضميرين، فيصعب تقطيعها |
| حرية الترتيب | «أكرم الأستاذ الطالب» | من أكرم من؟ لا يحسمها سوى الحركات الغائبة |
| الفصحى واللهجات | «شو بدك؟» و«إيش تبغى؟» و«عايز إيه؟» | ثلاث صيغ لسؤال واحد، بلا إملاء موحّد |
خذ التشكيل مثلاً. نقرأ العربية بلا حركات في الصحف والرسائل ومنصات التواصل، ونعتمد على السياق لنفهم. أما الآلة فتحتاج إلى ملايين الجمل كي تكتسب هذه القدرة البشرية. ثم يأتي الاشتقاق. فمعظم الكلمات تنطلق من جذر ثلاثي يتفرع منه أفعال وأسماء وصفات، وهذا ثراء جميل، لكنه يضاعف صور الكلمة الواحدة، وكل صورة تحتاج إلى أمثلة كافية. وهنا يبرز التحليل الصرفي، وهو مرحلة في معالجة اللغة الطبيعية تفكّك الكلمة إلى جذرها وسوابقها ولواحقها.
ولا تتوقف المشكلة هنا. ففي كتابة الناس اليومية تختلط الهمزات، وتتبادل التاء المربوطة والهاء مكانيهما، وتحل الياء محل الألف المقصورة. هذه الفروق الصغيرة لا تربك القارئ البشري، لكنها تبدو للآلة كلمات جديدة تماماً، فتتشتت الأمثلة التي كان يمكن أن تتجمع حول كلمة واحدة.
وتزيد حرية الترتيب الأمر تعقيداً. فيجوز في العربية أن نقدّم المفعول أو الجار والمجرور لغرض بلاغي، فتتبدل مواضع الكلمات والمعنى باقٍ. في المقابل، تعتمد الإنجليزية على ترتيب أشد صرامة، وهو أسهل على نماذج تتعلم من التسلسل. لذلك يحتاج فهم الجملة العربية إلى قراءة الإعراب والسياق معاً، لا إلى ترتيب الكلمات وحده. ومن هنا تتحول مسألة الذكاء الاصطناعي واللغة العربية إلى ورشة مشتركة بين اللغويين والمهندسين.
اللهجات العربية والذكاء الاصطناعي: الفصحى واللهجات وأزمة البيانات
تعيش العربية ازدواجاً مألوفاً: فصحى للكتابة الرسمية، ولهجات للحياة اليومية. وهنا تظهر المشكلة بوضوح في علاقة اللهجات العربية والذكاء الاصطناعي. فالناس يراسلون أصدقاءهم بلهجاتهم، وكثيراً ما يستبدلون الحروف العربية بحروف لاتينية وأرقام، كأن يكتبوا 3 مكان العين و7 مكان الحاء. وليس للهجات إملاء موحّد، فتتعدد طرق كتابة الكلمة نفسها. يضاف إلى ذلك أن كثيرين يخلطون العربية بالإنجليزية أو الفرنسية داخل الجملة الواحدة.
وحتى الصوت لا يسلم من الإشكال. فحين تتكلم مع مساعد ذكي بلهجتك، يحوّل النظام كلامك إلى نص أولاً، ثم يفهمه. وكل خطأ في المرحلة الأولى ينتقل إلى الثانية.
وتكمن العقدة الكبرى في البيانات، فهي حلقة الوصل بين الذكاء الاصطناعي واللغة العربية. فبحسب موقع W3Techs، تستخدم العربية في نحو 0.6% فقط من المواقع المصنّفة حسب اللغة، مع أن الناطقين بها مئات الملايين. تعني هذه الفجوة أن المحتوى الرقمي العربي أضعف حضوراً من أهله. كما ينحاز المتاح منه إلى الفصحى الإخبارية، أما اللهجات فتعيش في الصوت والمحادثات الخاصة.
والنتيجة تظهر في الأرقام. ففي اختبار استدلال واحد لم يتغير فيه سوى مستوى اللغة، سجّل نموذج «فنار» القطري في إصداره الأول نحو 68 بالفصحى، ونحو 64 بالمصرية، ونحو 59 بالشامية. أي أن الأداء انخفض في هذا الاختبار كلما ابتعد النص عن الفصحى. ولهذا يلحّ الباحثون على بناء بيانات لهجية موسومة، بدل الاكتفاء بما تنشره الصحافة. وهذا درس مهم لكل مهتم بالذكاء الاصطناعي واللغة العربية: الفصحى وحدها لا تكفي.
النماذج اللغوية العربية الصاعدة: نموذج جيس ونموذج كرنك وغيرهما
نبدأ بنموذج جيس. أطلقت «إنسبشن» (G42) بالتعاون مع جامعة محمد بن زايد للذكاء الاصطناعي و«سيريبراس» نسخته الأولى عام 2023 بحجم 13 مليار معلمة، ودرّبته على 395 مليار رمز عربي وإنجليزي. ثم جاء «جيس 2» في ديسمبر 2025 بحجم 70 مليار معلمة وتدريب على أكثر من 600 مليار رمز عربي، منها أكثر من 427 ألف قصيدة موسومة. وهو مفتوح الأوزان، أي يستطيع المطوّرون تنزيله وتشغيله بأنفسهم.
أما نموذج كرنك فمصري المنشأ. طوّره مركز الابتكار التطبيقي التابع لوزارة الاتصالات وتكنولوجيا المعلومات، وكشف عنه في قمة AI Everything بالقاهرة مطلع 2026. ووصفه مركز المعلومات ودعم اتخاذ القرار بمجلس الوزراء بأنه أعلى نموذج عربي تصنيفاً في فئتي 30–40 و70–80 مليار معلمة، وبأنه يسدّ فجوة فهم السياق الثقافي العربي. ويفهم العامية ويحوّل الصوت إلى نص، وتقوم عليه تطبيقات مثل «سيا»، المعلّم الذكي لمقرر اللغة العربية والتاريخ المصري.
كما أطلق معهد الابتكار التكنولوجي في أبوظبي «فالكون H1 العربي» مطلع 2026، وبنت السعودية «علّام» الذي يشغّل «هيوماين شات»، وأصدر معهد قطر لبحوث الحوسبة «فنار 2» في مارس 2026. ويلخّص الجدول التالي أبرزها، مع التنبيه أن مراتب التقييم تتبدل مع كل إصدار جديد.
| النموذج | الجهة | الحجم | ما يميّزه |
|---|---|---|---|
| جيس 2 | إنسبشن (G42) وجامعة محمد بن زايد وسيريبراس، الإمارات | 8 و70 مليار معلمة | مفتوح الأوزان، ودُرّب على أكثر من 600 مليار رمز عربي |
| كرنك | مركز الابتكار التطبيقي، مصر | فئة 30–40 مليار | يراعي العامية المصرية والسياق المحلي |
| فالكون H1 العربي | معهد الابتكار التكنولوجي، أبوظبي | 3 و7 و34 مليار | تصدّر لوحة Open Arabic LLM عند إطلاقه بحسب الجهة المطوّرة |
| علّام | سدايا وهيوماين، السعودية | 7 و34 مليار | يشغّل «هيوماين شات» |
| فنار 2 | معهد قطر لبحوث الحوسبة، قطر | 27 مليار | مفتوح بترخيص Apache 2.0، وصدر في مارس 2026 |
ويبقى سؤال مهم في مجال الذكاء الاصطناعي واللغة العربية: هل تتفوق النماذج العربية على العالمية دائماً؟ ليس بالضرورة. فالنماذج العالمية الكبرى قوية في الفصحى الرسمية والمهام العامة، لكن الفارق يظهر في اللهجات والسياق الثقافي والشعر.
تطبيقات عملية: التعليم والخدمات الحكومية وفهم اللهجات
لا تبقى هذه النماذج حبيسة المختبرات. فهي تدخل تدريجياً في الحياة اليومية، وتظهر ثمار الذكاء الاصطناعي واللغة العربية في ثلاثة ميادين.
- التعليم: يشرح «سيا» دروس اللغة العربية والتاريخ لطلاب الثانوية. وفي أبوظبي طوّرت جامعة نيويورك أبوظبي مع مركز أبوظبي للغة العربية مدوّنة BAREC لقياس سهولة قراءة النصوص. تتدرج مستوياتها التسعة عشر من رياض الأطفال إلى الدراسات العليا، فيسهل على المعلّم اختيار نص يناسب قارئه.
- الخدمات الحكومية: تعتمد منصة «خدمات مصر الرقمية» على معالجة اللغة لمراجعة مكالمات مركز الاتصال. كما يتيح مساعد ذكي إرشاداً قانونياً وتنظيمياً للمواطنين والشركات الصغيرة.
- فهم الصوت واللهجات: يحوّل كرنك الكلام بالعامية المصرية إلى نص مكتوب، وهي مهمة صعبة لأن اللهجة لا تلتزم بإملاء ثابت.
وللمدوّنين وصنّاع المحتوى فائدة خاصة. فهذه الأدوات تساعد في المسودة الأولى والتلخيص واقتراح العناوين، لكن اللمسة النهائية تبقى بشرية، لأن القارئ العربي يلتقط الركاكة بسرعة ويفرّق بين نص كتبه إنسان ونص ترجمته آلة.
وتبقى هذه الأمثلة مبكرة، لكنها تُظهر أن الذكاء الاصطناعي واللغة العربية بدآ يلتقيان في خدمات يلمسها الناس.
الذكاء الاصطناعي واللغة العربية: خدمة للهوية أم تهديد لها؟
السؤال مشروع، والإجابة ليست بالأبيض والأسود. من جهة، تفتح هذه النماذج أبواباً واسعة. فهي تتيح لمن لا يتقن الإنجليزية الوصول إلى المعرفة بلغته، وتثري المحتوى الرقمي العربي بنصوص جديدة. كما تحفظ جانباً من التراث، إذ تعلّم «جيس 2» من مئات آلاف القصائد.
ومن جهة أخرى، تحمل المسألة مخاطر. فالنماذج التي تتعلم من نصوص عربية مترجمة آلياً تنتج عربية ركيكة تشبه الإنجليزية في بنائها. وإذا طغت لهجة واحدة على بيانات التدريب فقدت لهجات أخرى حضورها. وقد يخطئ النموذج في السياق الثقافي، فيخلط بين عادات بلدين أو ينسب بيتاً إلى غير قائله. لذلك يضع الباحثون الأمن اللغوي العربي في صلب النقاش.
الخلاصة أن الخطر لا يكمن في الأداة نفسها، بل في غياب المحتوى العربي الأصيل الذي تتغذى عليه. فمستقبل الذكاء الاصطناعي واللغة العربية يتوقف على ما نكتبه اليوم: كلما كتبنا أكثر وأفضل، تعلمت الآلة منا أكثر. ولهذا تتجه مبادرات عدة إلى بناء مدونات عربية نظيفة ومفتوحة، فمن يملك البيانات يملك جزءاً من القرار.
ماذا ينتظر العربية رقمياً؟ من لغة «مدعومة» إلى لغة «متقنة»
يفصل بين اللغة «المدعومة» واللغة «المتقنة» شيء واحد: الجودة في التفاصيل. فالنموذج المدعوم يجيب بالعربية، أما المتقن فيفهم نكتتك وسياقك ولهجتك ويكتب بأسلوب لا يبدو مترجماً. وللوصول إلى هذه المرحلة تبرز أربعة مسارات أمام الذكاء الاصطناعي واللغة العربية:
- بيانات لهجية موسومة ومفتوحة، تُجمع بموافقة أصحابها وتغطي المغرب العربي والخليج والشام ومصر والسودان.
- مقاييس تقييم عربية أصيلة تختبر الثقافة والشعر والسياق، لا الترجمة وحدها.
- نماذج تفهم الصوت والنص معاً، لأن كثيراً من العرب يتحدثون أكثر مما يكتبون.
- شراكة بين اللغويين والمهندسين، فلا يكفي أن يبني المهندس النموذج دون أن يراجعه لغوي.
ويتقاطع هذا كله مع نقاش أكاديمي نشط. فينظّم مركز ابن خلدون في جامعة قطر مؤتمر تجسير السنوي الرابع يومي 9 و10 نوفمبر 2026 تحت عنوان «الذكاء الاصطناعي وإثراء المحتوى الرقمي العربي». ويناقش المشاركون فيه كيف تنتقل العربية من موقع المستهلك للتقنية إلى موقع المنتج لها.
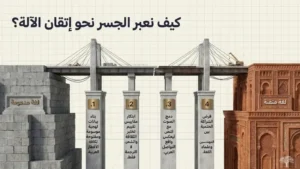
حين تتحقق هذه الشروط، لن يسأل أحد: هل يفهم الذكاء الاصطناعي اللغة العربية؟ بل سيسأل: ماذا نصنع به؟ وفي النهاية، العربية لغة حيّة عاشت قروناً وتجاوزت أدوات كثيرة، وسيجد الذكاء الاصطناعي واللغة العربية طريقهما معاً، بشرط أن نشارك في تعليم الآلة بدل أن نكتفي بالتفرج.
اقرأ أيضاً على مدونتنا:
- اغتراب المعنى: هل يبتلع الذكاء الاصطناعي “بصمة” المثقف العربي؟
- مستقبل الذكاء الاصطناعي 2030: التوقعات، المخاطر، والفرص القادمة
- السيادة الرقمية: لماذا تتسابق الدول على بناء ذكاء اصطناعي خاص بها؟
خطوات عملية: كيف تحصل على نتائج أفضل بالعربية اليوم؟
لا تنتظر حتى تكتمل المنظومة، فثمة ما تفعله الآن. جرّب تجربة صغيرة أولاً: اكتب «ما أحسن السماء» بلا تشكيل في أي نموذج، واسأله عن معناها. فإن اكتفى بمعنى واحد فقد رأيت المشكلة بعينيك. ثم طبّق هذه الخطوات:
- حدّد المستوى والأسلوب: اطلب «فصحى مبسّطة» أو «لهجة سعودية» أو «لهجة مغربية»، ولا تترك النموذج يخمّن.
- شكّل الكلمة الملتبسة فقط، فحركة واحدة تحسم المعنى وتوفر عليك التصحيح.
- اطلب من النموذج أن يسألك عند الغموض، أو أن يذكر المعاني المحتملة قبل أن يجيب.
- أعطه عيّنة قصيرة من الأسلوب الذي تريده، فالأمثلة تقلّل الاعتماد على التخمين.
- راجع الأسماء والتواريخ والأبيات التراثية بنفسك، فقد يخطئ النموذج في نسبة الأقوال.
- قارن بين أكثر من نموذج عربي على نصوصك أنت، فلوحات الترتيب لا تعكس دائماً حاجتك.
وهكذا يصبح عملك مع الذكاء الاصطناعي واللغة العربية أدق وأكثر أماناً.
أسئلة شائعة عن الذكاء الاصطناعي واللغة العربية
هل يفهم الذكاء الاصطناعي اللغة العربية فعلاً؟
يفهم الفصحى المعاصرة جيداً في الغالب، لكنه يتعثر مع الغموض والتراث واللهجات والسياق الثقافي. والفهم هنا إحصائي، يقوم على توقع الأنسب لا على وعي بالمعنى.
لماذا تبدو الترجمة إلى العربية أضعف من الإنجليزية أحياناً؟
لأن بيانات التدريب العربية أقل، ولأن أدوات التقطيع تفتّت الكلمة العربية، ولأن بعض النماذج تعلمت من نصوص مترجمة فورثت ركاكتها.
كيف يتعامل الذكاء الاصطناعي مع اللهجات؟
يتفاوت الأداء بحسب اللهجة وحجم بياناتها، وتتفوق الفصحى عادة. وتحاول نماذج مثل كرنك وجيس 2 سدّ الفجوة بتدريب موجّه على اللهجات.
ما أفضل النماذج اللغوية العربية المتاحة اليوم؟
لا يوجد «أفضل» مطلق. فقد تصدّر فالكون H1 العربي لوحة التقييم الأكاديمية عند إطلاقه، ويتميز جيس 2 بحجمه وبخبرته بالشعر، ويخدم كرنك السياق المصري. اختر بحسب مهمتك وجرّب على نصوصك.
هل سيهدد الذكاء الاصطناعي اللغة العربية أم يخدمها؟
الأداة محايدة. فإن غذّيناها بمحتوى عربي أصيل وجيد خدمت اللغة، وإن تركناها تتعلم من الترجمات الركيكة أضعفتها.
ما أثر غياب التشكيل على فهم الآلة للنص؟
يرفع احتمالات التأويل، لأن الكلمة الواحدة قد تحمل عدة قراءات. وتعتمد النماذج الحديثة على السياق لترجيح المعنى، لكنها تخطئ حين يكون السياق قصيراً أو غامضاً.